
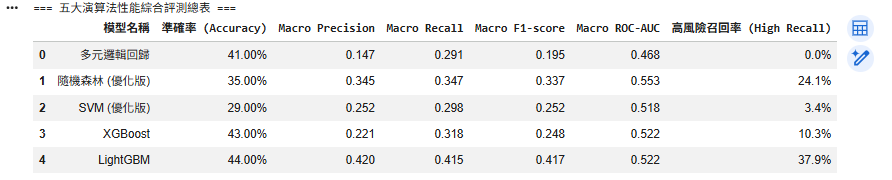
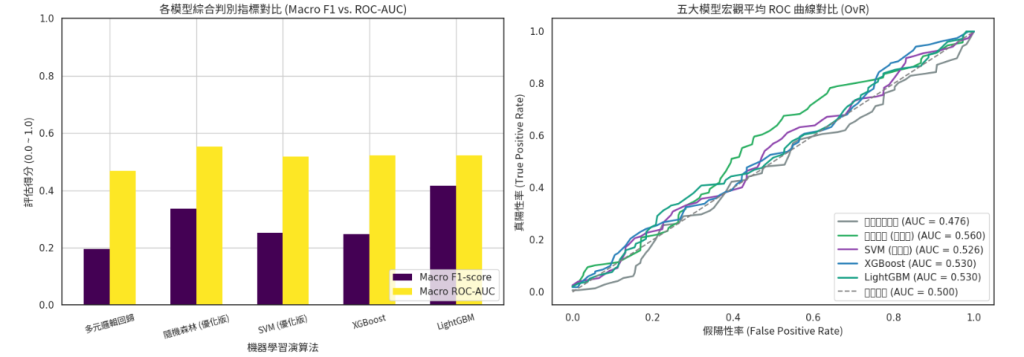
系統性彙整 Day 19 至 Day 23 實作的五大機器學習分類演算法——多元邏輯回歸(Logistic Regression)、隨機森林(Random Forest 優化版)、支援向量機(SVM 優化版)、XGBoost 以及 LightGBM。計算一對其餘(One-vs-Rest, OvR)多類別微平均/宏平均 ROC-AUC,繪製全模型綜合指標橫向對比條形圖與多類別 ROC 曲線,完成鐵人賽預測建模階段的冠軍模型決選。
一、實作前情境:如何客觀選出真正能落地的最佳模型?
在過去五天的密集建模實戰中,我們見證了不同演算法在面對用眼疲勞資料時的特性:
二、撰寫五大模型綜合評測與多類別 ROC 曲線腳本
在Colab中新增儲存格,統整各模型的預測結果與預測機率,繪製1x2橫向對比圖表:
# ==========================================
# Day 24:五大機器學習模型終極對決與 ROC-AUC 評測
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm
import pandas as pd
import numpy as np

from sklearn.preprocessing import label_binarize
from sklearn.metrics import (
    accuracy_score, precision_score, recall_score, f1_score,
    roc_curve, auc, roc_auc_score
)

# 1. 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 2. 收集各模型實例與預測結果 (確保先前的模型變數已存在)
# y_test 二值化矩陣 (用於計算多類別 One-vs-Rest ROC 曲線)
y_test_bin = label_binarize(y_test, classes=[0, 1, 2])
n_classes = y_test_bin.shape[1]

models_dict = {
    '多元邏輯回歸': {'pred': clf.predict(X_test), 'prob': clf.predict_proba(X_test)},
    '隨機森林 (優化版)': {'pred': best_rf.predict(X_test), 'prob': best_rf.predict_proba(X_test)},
    'SVM (優化版)': {'pred': best_svm.predict(X_test), 'prob': best_svm.predict_proba(X_test)},
    'XGBoost': {'pred': xgb_clf.predict(X_test), 'prob': xgb_clf.predict_proba(X_test)},
    'LightGBM': {'pred': lgb_clf.predict(X_test), 'prob': lgb_clf.predict_proba(X_test)}
}

# 3. 計算綜合性能評測指標表
benchmarks = []

for name, res in models_dict.items():
    y_pred = res['pred']
    y_prob = res['prob']

    acc = accuracy_score(y_test, y_pred)
    macro_prec = precision_score(y_test, y_pred, average='macro', zero_division=0)
    macro_rec = recall_score(y_test, y_pred, average='macro', zero_division=0)
    macro_f1 = f1_score(y_test, y_pred, average='macro', zero_division=0)

    # 計算 Macro-average One-vs-Rest ROC-AUC
    try:
        ovr_auc = roc_auc_score(y_test_bin, y_prob, average='macro', multi_class='ovr')
    except:
        ovr_auc = 0.5

    # 計算高度風險 (類別 2) 單獨的召回率
    rec_high = recall_score(y_test == 2, y_pred == 2, zero_division=0)

    benchmarks.append({
        '模型名稱': name,
        '準確率 (Accuracy)': f"{acc*100:.2f}%",
        'Macro Precision': round(macro_prec, 3),
        'Macro Recall': round(macro_rec, 3),
        'Macro F1-score': round(macro_f1, 3),
        'Macro ROC-AUC': round(ovr_auc, 3),
        '高風險召回率 (High Recall)': f"{rec_high*100:.1f}%"
    })

benchmark_df = pd.DataFrame(benchmarks)
print("=== 五大演算法性能綜合評測總表 ===")
display(benchmark_df)

# 4. 繪製 1x2 畫布:核心指標橫向長條圖 + 宏觀 ROC 曲線對比
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="whitegrid")

# --- 圖 1:Macro F1-score 與 ROC-AUC 綜合評分長條圖 ---
plot_df = pd.DataFrame({
    '模型名稱': [b['模型名稱'] for b in benchmarks],
    'Macro F1-score': [b['Macro F1-score'] for b in benchmarks],
    'Macro ROC-AUC': [b['Macro ROC-AUC'] for b in benchmarks]
}).set_index('模型名稱')

plot_df.plot(kind='bar', ax=axes[0], colormap='viridis', width=0.6, edgecolor='none')
axes[0].set_title('各模型綜合判別指標對比 (Macro F1 vs. ROC-AUC)', fontproperties=my_font, fontsize=13, fontweight='bold')
axes[0].set_xlabel('機器學習演算法', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('評估得分 (0.0 ~ 1.0)', fontproperties=my_font, fontsize=12)
axes[0].set_xticklabels(axes[0].get_xticklabels(), fontproperties=my_font, rotation=15, fontsize=10)
axes[0].set_ylim(0, 1.0)
axes[0].legend(loc='lower right')

# --- 圖 2:宏觀平均 ROC 曲線對比 (Macro-average ROC Curves) ---
colors = ['#7f8c8d', '#27ae60', '#8e44ad', '#2980b9', '#16a085']

for (name, res), color in zip(models_dict.items(), colors):
    y_prob = res['prob']

    # 計算每一類的 FPR / TPR 並合成宏觀平均曲線
    all_fpr = np.unique(np.concatenate([roc_curve(y_test_bin[:, i], y_prob[:, i])[0] for i in range(n_classes)]))
    mean_tpr = np.zeros_like(all_fpr)
    for i in range(n_classes):
        fpr_i, tpr_i, _ = roc_curve(y_test_bin[:, i], y_prob[:, i])
        mean_tpr += np.interp(all_fpr, fpr_i, tpr_i)
    mean_tpr /= n_classes
    macro_auc = auc(all_fpr, mean_tpr)

    axes[1].plot(all_fpr, mean_tpr, label=f'{name} (AUC = {macro_auc:.3f})', color=color, linewidth=2)

axes[1].plot([0, 1], [0, 1], 'k--', linestyle='--', color='gray', label='隨機猜測 (AUC = 0.500)')
axes[1].set_title('五大模型宏觀平均 ROC 曲線對比 (OvR)', fontproperties=my_font, fontsize=13, fontweight='bold')
axes[1].set_xlabel('假陽性率 (False Positive Rate)', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('真陽性率 (True Positive Rate)', fontproperties=my_font, fontsize=12)
axes[1].legend(loc='lower right')

plt.tight_layout()
plt.show()
三、圖表解讀與客觀數據分析
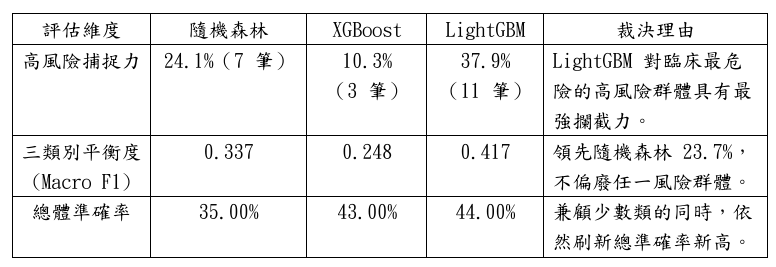
b.雙核心指標雙料冠軍:LightGBM:
c.穩健防線:隨機森林:


 iThome鐵人賽
 看影片追技術